Руководство по продукту
Проектирование комплаентных ИИ-голосовых агентов: руководство по идентификации и суверенитету данных
Узнайте, как проектировать комплаентные ИИ-голосовые агенты с помощью пре-колл аналитики, прозрачного логирования, перевода на оператора и суверенитета данных.
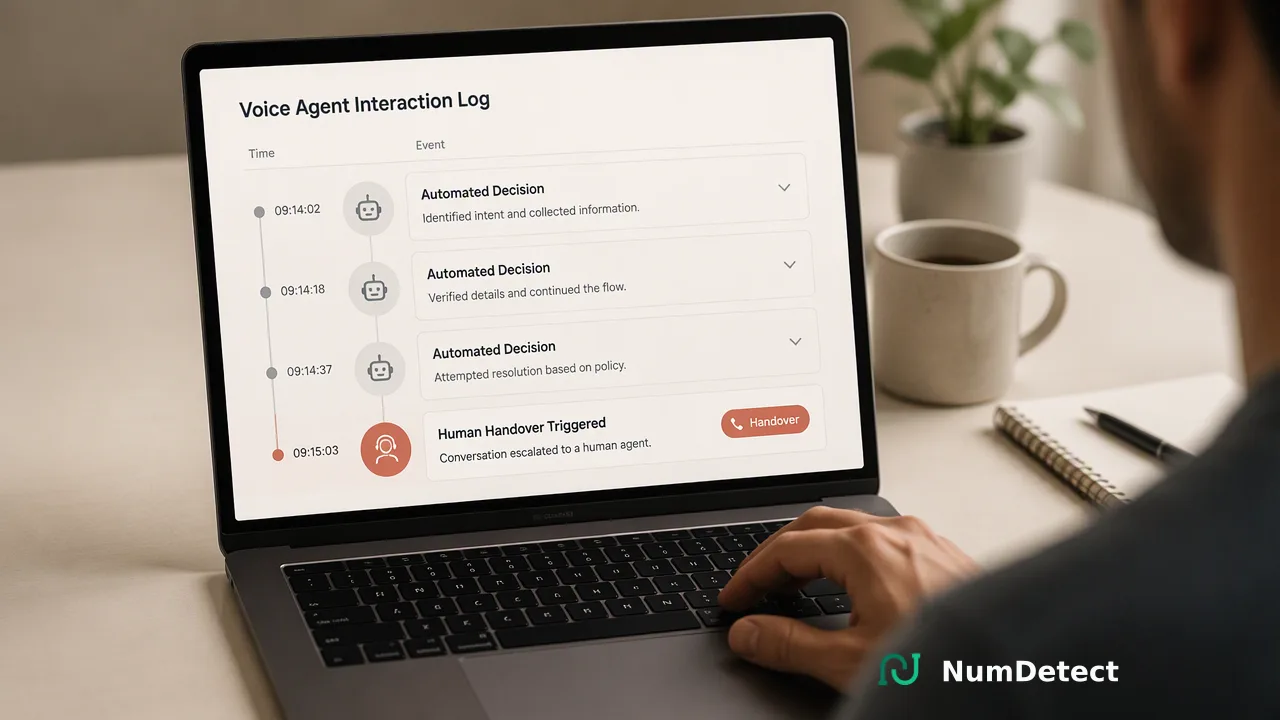
Внедрение комплаентных ИИ-голосовых агентов требует обеспечения суверенитета данных, автоматизированного логирования решений, прозрачной передачи вызовов оператору и строгой гигиены данных перед совершением звонка.
Проектирование комплаентных ИИ-голосовых агентов требует приведения операционных процессов в соответствие с региональным законодательством, обеспечения сквозной аудируемости и соблюдения дисциплины в работе с данными. В современных контакт-центрах идентификация ИИ-голосовых агентов опирается на многоуровневые сигналы верификации, а не на единичные предположения. Внедряя асинхронную пакетную проверку номеров телефонов перед звонком наряду со структурированным автоматизированным логированием решений, организации могут подготавливать и очищать списки контактов перед запуском исходящих кампаний. Такая гигиена данных до начала взаимодействия поддерживает соблюдение нормативных требований за счет минимизации избыточной обработки данных, подтверждения контекста телекоммуникаций и обеспечения прозрачной работы автоматизированных голосовых систем в рамках установленных юрисдикционных границ и строгих принципов суверенитета данных.
Императив комплаенса в ИИ-голосовой оркестрации
Выбор решений для ИИ-контакт-центров требует приоритета прозрачности, суверенитета данных и аудируемости для соответствия развивающимся стандартам автоматизированного принятия решений. Современная голосовая оркестрация вышла за рамки простых метрик переадресации вызовов, где успех оценивался преимущественно объемом удержания.
Сегодня эффективность контакт-центра сосредоточена на показателях разрешения вопросов, которые отражают точные и соответствующие требованиям результаты для клиентов. Регулируемые отрасли сталкиваются с пристальным вниманием к тому, как автоматизированные голосовые агенты обрабатывают персональные записи, аутентифицируют абонентов и принимают решения в реальном времени. Когда автоматизированные системы принимают несанкционированные решения или неверно маршрутизируют конфиденциальные запросы, организации сталкиваются с серьезными рисками нарушения комплаенса. Приоритет аудируемости на начальном этапе проектирования помогает командам документировать каждый шаг жизненного цикла голосового взаимодействия, демонстрируя, что операционные правила и этические меры безопасности регулируют каждый автоматизированный вызов.
Приоритет суверенитета и резидентности данных
Суверенитет данных представляет собой принцип, согласно которому цифровая информация остается под действием законов и систем управления той страны, где она была собрана или обработана. При развертывании глобальных ИИ-голосовых систем управление резидентностью данных имеет решающее значение для выбора базовой телефонии, хостинга моделей и сервисов верификации.
Международные системы накладывают строгие ограничения на трансграничную передачу данных. Например, согласно GDPR Article 5 (Regulation (EU) 2016/679), персональные данные должны быть адекватными, релевантными и ограниченными тем, что необходимо для целей их обработки. Голосовые архитектуры, которые обрабатывают аудиозаписи абонентов, транскрипты и метаданные в разных юрисдикциях без региональных мер защиты, рискуют столкнуться с существенными юридическими штрафами. Установление четких границ резидентности данных гарантирует, что ИИ-обработка, синтез голоса и конвейеры аналитики соответствуют местным телекоммуникационным нормам и требованиям конфиденциальности.
Усиление точности ИИ с помощью пре-колл аналитики
Операционная гигиена перед началом вызова поддерживает комплаенс и защищает репутацию контакт-центра. NumDetect — это платформа для асинхронной пакетной проверки номеров телефонов, предназначенная для команд и разработчиков, подготавливающих большие списки номеров для очистки, сегментации, обогащения CRM, регионального анализа и операционной приоритизации.
Вместо выполнения запросов в реальном времени во время активного вызова, команды могут отправлять пакетные файлы (используя форматы TXT или CSV, по одному номеру в строке) для оценки качества списка в асинхронном режиме. Глобальный поиск оператора возвращает контекст оператора для записей номеров телефонов в рамках асинхронного пакетного процесса, помогая системам определять региональные параметры телекоммуникаций. Подготовка данных перед звонком помогает командам фильтровать неактивные линии, сегментировать очереди маршрутизации и применять специфические для юрисдикции правила совершения вызовов, поддерживая комплаенс без внесения задержек в работу голосовых моделей. Обратите внимание, что номера материкового Китая (+86) не поддерживаются в этом пакетном процессе.
Проектирование для аудируемости и перевода на оператора
Комплаенс в автоматизированных голосовых системах зависит от полной прозрачности автоматизированных решений. Автоматизированное логирование решений необходимо для аудируемости, фиксируя, почему именно агент выбрал конкретную ветку диалога, запросил дополнительную аутентификацию или пометил взаимодействие для проверки.
Не менее важен дизайн прозрачной передачи вызовов между ИИ-агентами и операторами-людьми. Когда голосовой агент сталкивается с неоднозначным намерением клиента, потенциальными сигналами мошенничества с идентификацией или недовольством клиента, он должен корректно перевести сессию, не теряя контекста разговора. Логирование полной истории взаимодействия, включая сигналы маршрутизации до звонка и контрольные точки принятия решений во время звонка, дает операторам-людям необходимую информацию для решения сложных запросов, создавая при этом неизменяемый аудиторский след для внутренних проверок комплаенса.
Управление рисками поставщиков через заменяемые компоненты
Опора на жестко связанные монолитные платформы контакт-центров создает значительные риски, связанные с поставщиками. Если один провайдер меняет условия управления данными, сталкивается с простоями или не соответствует местным стандартам суверенитета данных, вся голосовая операция оказывается под угрозой срыва.
Проектирование голосовых стеков с использованием модульных, заменяемых компонентов позволяет организациям отделить большие языковые модели, операторов телефонии, движки распознавания речи и сервисы аналитики данных. Например, использование специализированных инструментов для очистки пакетных списков отдельно от основного процесса выполнения диалога позволяет командам заменять базовые ИИ-модели или телеком-провайдеров по мере изменения регуляторных требований. Такая архитектурная гибкость снижает долгосрочную зависимость от поставщика, усиливает контроль управления и обеспечивает непрерывную операционную устойчивость в условиях меняющегося глобального регуляторного ландшафта.
Часто задаваемые вопросы
Как пакетная проверка номеров телефонов поддерживает ИИ-комплаенс?
Пакетная проверка номеров телефонов помогает командам очищать списки для исходящих вызовов до того, как автоматизированные голосовые системы начнут взаимодействовать с контактами. Оценивая списки асинхронно, организации могут выявлять нераспределенные записи и добавлять сетевой контекст без сбора инвазивных данных об абонентах. Это приводит процессы в соответствие с принципами минимизации данных, ограничивает нежелательные автоматизированные звонки и предоставляет проверяемые записи о должной осмотрительности перед звонком для регуляторных аудитов.
Почему асинхронная обработка предпочтительна для подготовки данных ИИ-голосовых агентов в больших масштабах?
Асинхронная обработка позволяет инженерным командам оценивать большие наборы данных с помощью пакетной отправки файлов без внесения задержек в вызовы в реальном времени. Системы могут загружать списки в виде файлов TXT или CSV, содержащих по одному номеру в строке, для получения данных о сети и активности в офлайн-режиме. Это отделение процессов гигиены данных от клиентской телекоммуникационной инфраструктуры поддерживает операционную эффективность.
Какова роль минимизации данных в архитектуре ИИ-голосовых агентов?
Минимизация данных требует сбора и обработки только тех данных, которые строго необходимы для конкретного взаимодействия. В архитектурах голосовых агентов опора на легковесные операционные сигналы — такие как статус активности или контекст оператора — вместо хранения чувствительных персональных идентификаторов снижает риски раскрытия данных и помогает выполнять законодательные обязательства в рамках таких систем, как GDPR.
Узнайте больше
Выберите информацию о продукте, которая соответствует следующему этапу вашего рабочего процесса.