Produktleitfaden
Architektur konformer KI-Sprachassistenten: Ein Leitfaden zu Identität und Datensouveränität
Erfahren Sie, wie Sie konforme KI-Sprachassistenten mit Vorab-Intelligenz, transparenten Protokollen, menschlicher Übergabe und Datensouveränität gestalten.
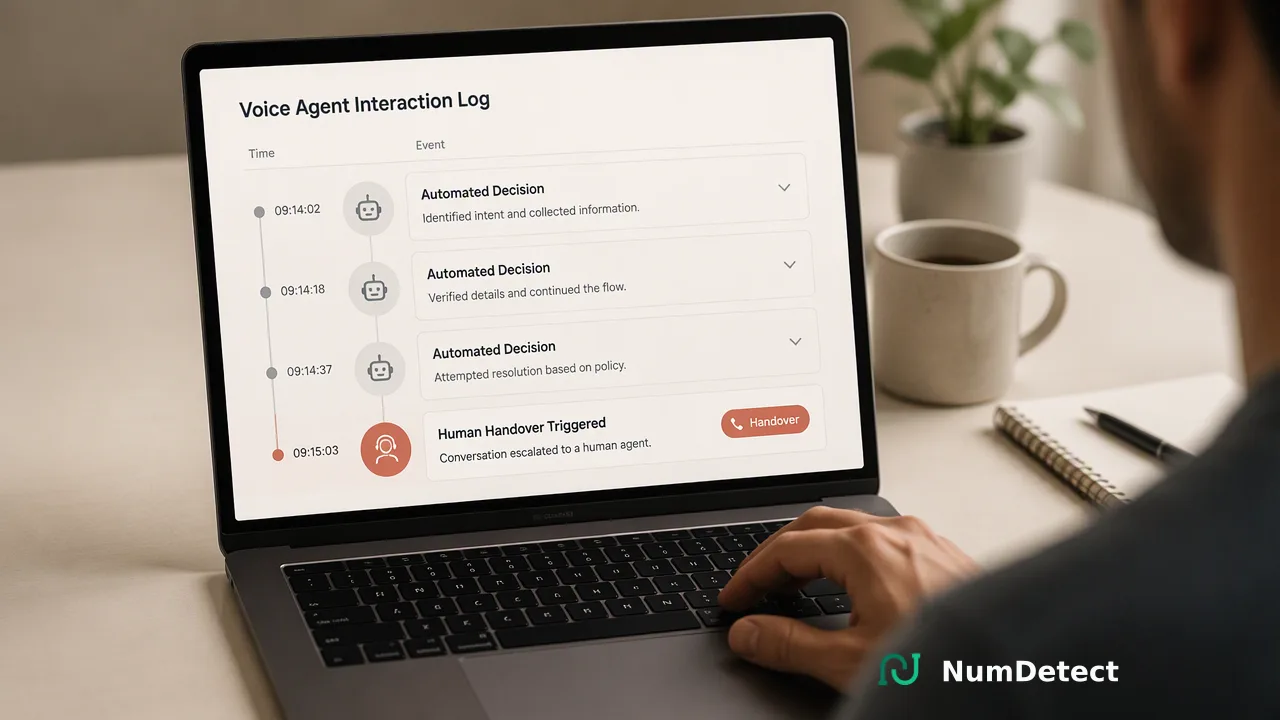
Der Einsatz konformer KI-Sprachassistenten erfordert klare Datensouveränität, automatisierte Entscheidungsprotokolle, transparente Übergaben und eine rigorose Datenhygiene vor dem Anruf.
Die Architektur konformer KI-Sprachassistenten erfordert die Abstimmung operativer Arbeitsabläufe mit regionalen Governance-Vorgaben, durchgängiger Revisionsfähigkeit und disziplinierter Datenhygiene. In modernen Contact Centern stützt sich die Identitätsprüfung bei KI-Sprachassistenten auf mehrschichtige Verifizierungssignale anstatt auf einzelne Annahmen. Durch die Implementierung asynchroner Massenabfragen von Telefonnummern vor dem Anruf in Verbindung mit einer strukturierten, automatisierten Entscheidungsprotokollierung können Unternehmen Kontaktlisten bereinigen und vorbereiten, bevor sie die Kontaktaufnahme starten. Diese Hygiene vor der Interaktion unterstützt die Einhaltung gesetzlicher Vorschriften, indem sie unnötige Datenverarbeitung minimiert, den telekommunikativen Kontext bestätigt und sicherstellt, dass automatisierte Sprachsysteme transparent innerhalb festgelegter Zuständigkeitsbereiche und strenger Rahmenbedingungen zur Datensouveränität agieren.
Das Compliance-Gebot bei der KI-Sprachorchestrierung
Die Auswahl von KI-Lösungen für Contact Center erfordert die Priorisierung von Transparenz, Datensouveränität und Revisionsfähigkeit, um den sich entwickelnden regulatorischen Standards für automatisierte Entscheidungsfindungen gerecht zu werden. Die moderne Sprachorchestrierung ist über einfache Metriken zur Anrufumleitung hinausgewachsen, bei denen der Erfolg primär an der Anzahl der abgewickelten Anrufe gemessen wurde.
Heute konzentriert sich die Leistung von Contact Centern auf qualitätsbasierte Lösungsraten, die präzise und konforme Kundenergebnisse widerspiegeln. Regulierte Branchen sehen sich einer genauen Prüfung gegenüber, wie automatisierte Sprachassistenten mit persönlichen Datensätzen umgehen, Anrufer authentifizieren und Entscheidungen in Echtzeit treffen. Wenn automatisierte Systeme unbefugte Entscheidungen treffen oder sensible Anfragen falsch weiterleiten, drohen Unternehmen erhebliche Compliance-Risiken. Die Priorisierung der Revisionsfähigkeit bereits in der architektonischen Anfangsphase hilft Teams dabei, jeden Schritt des Lebenszyklus einer Sprachinteraktion zu dokumentieren und nachzuweisen, dass operative Regeln und ethische Schutzmaßnahmen jeden automatisierten Anruf steuern.
Priorisierung von Datensouveränität und Datenresidenz
Datensouveränität repräsentiert das Prinzip, dass digitale Informationen den Gesetzen und Governance-Rahmenbedingungen des Landes unterliegen, in dem sie erhoben oder verarbeitet werden. Beim Einsatz globaler KI-Sprachsysteme ist die Verwaltung der Datenresidenz entscheidend für die Auswahl der zugrunde liegenden Telefonie-, Modell-Hosting- und Verifizierungsdienste.
Internationale Rahmenwerke legen strenge Grenzen für grenzüberschreitende Datentransfers fest. Gemäß GDPR Article 5 (Regulation (EU) 2016/679) müssen personenbezogene Daten angemessen, relevant und auf das für die Zwecke der Verarbeitung notwendige Maß beschränkt sein. Spracharchitekturen, die Anrufer-Audio, Transkripte und Metadaten über ausländische Rechtsgebiete hinweg ohne regionale Schutzmaßnahmen verarbeiten, riskieren erhebliche rechtliche Sanktionen. Die Festlegung klarer Grenzen für die Datenresidenz stellt sicher, dass KI-Verarbeitung, Sprachsynthese und Analyse-Pipelines lokale Telekommunikationsvorschriften und Datenschutzvorgaben respektieren.
Stärkung der KI-Genauigkeit durch Vorab-Intelligenz
Operative Hygiene vor der Anrufinitiierung unterstützt die Compliance und schützt den Ruf des Contact Centers. NumDetect ist eine asynchrone Plattform für Massenabfragen von Telefonnummern für Teams und Entwickler, die große Nummernlisten für Bereinigung, Segmentierung, CRM-Anreicherung, regionale Analysen und operative Priorisierung vorbereiten.
Anstatt Echtzeit-Abfragen während eines laufenden Wählvorgangs durchzuführen, können Teams Massendateien (im TXT- oder CSV-Format mit einer Nummer pro Zeile) einreichen, um die Listenqualität asynchron zu bewerten. Die Globale Netzbetreiberabfrage liefert Netzbetreiber-Kontext für Telefonnummerndatensätze in einem asynchronen Massen-Workflow und hilft Systemen dabei, regionale Telekommunikationsparameter zu bestimmen. Die Datenvorbereitung vor dem Anruf hilft Teams dabei, inaktive Leitungen zu filtern, Routing-Warteschlangen zu segmentieren und rechtsspezifische Anrufregeln anzuwenden, was die Compliance unterstützt, ohne Latenzzeiten in die Laufzeit-Sprachmodelle einzuführen. Beachten Sie, dass Nummern aus Festlandchina in diesem Massen-Workflow nicht unterstützt werden.
Design für Revisionsfähigkeit und menschliche Übergabe
Compliance in automatisierten Sprachsystemen hängt von der vollständigen Sichtbarkeit automatisierter Entscheidungen ab. Eine automatisierte Entscheidungsprotokollierung ist für die Revisionsfähigkeit unerlässlich, da sie genau aufzeichnet, warum ein Assistent einen bestimmten Dialogzweig ausgewählt, eine zusätzliche Authentifizierung angefordert oder eine Interaktion zur Überprüfung markiert hat.
Ebenso wichtig ist das Design transparenter Übergaben zwischen KI-Assistenten und menschlichen Mitarbeitern. Wenn ein Sprachassistent auf mehrdeutige Kundenabsichten, potenzielle Anzeichen von Identitätsbetrug oder Kundenfrustration stößt, muss er die Sitzung sauber übertragen, ohne den Gesprächskontext zu verlieren. Die Protokollierung der vollständigen Interaktionshistorie – einschließlich Routing-Signalen vor dem Anruf und Entscheidungspunkten während des Anrufs – gibt menschlichen Mitarbeitern den notwendigen Hintergrund, um komplexe Anfragen zu lösen, und erstellt gleichzeitig einen unveränderlichen Prüfpfad für interne Compliance-Überprüfungen.
Management von Anbieterrisiken durch austauschbare Komponenten
Die Abhängigkeit von eng gekoppelten, monolithischen Contact-Center-Plattformen schafft erhebliche Anbieterrisiken. Wenn ein einzelner Anbieter seine Datengovernance-Bedingungen ändert, Ausfallzeiten erlebt oder lokale Standards zur Datensouveränität nicht erfüllt, ist der gesamte Sprachbetrieb gestört.
Die Architektur von Sprach-Stacks mit modularen, austauschbaren Komponenten ermöglicht es Unternehmen, große Sprachmodelle, Telefonie-Anbieter, Spracherkennungs-Engines und Datenintelligenz-Dienste zu entkoppeln. Beispielsweise ermöglicht die Verwendung spezialisierter Tools für die Massenbereinigung von Listen, getrennt von der eigentlichen Gesprächsausführung, den Teams den Austausch zugrunde liegender KI-Modelle oder Telekommunikationsanbieter bei sich ändernden regulatorischen Anforderungen. Diese architektonische Flexibilität mindert die langfristige Anbieterbindung, stärkt Governance-Kontrollen und stellt eine unterbrechungsfreie operative Resilienz über sich wandelnde globale regulatorische Landschaften hinweg sicher.
FAQ
Wie unterstützt die Massenabfrage von Telefonnummern die KI-Compliance?
Die Massenabfrage von Telefonnummern hilft Teams dabei, Kontaktlisten zu bereinigen, bevor automatisierte Sprachsysteme Kontakte ansprechen. Durch die asynchrone Bewertung von Listen können Unternehmen nicht zugeordnete Datensätze identifizieren und Netzwerkkontext hinzufügen, ohne invasive Teilnehmerdetails zu erfassen. Dies stimmt Arbeitsabläufe mit Prinzipien der Datenminimierung ab, begrenzt unerwünschte automatisierte Anrufe und liefert überprüfbare Aufzeichnungen der Sorgfaltspflicht vor dem Anruf für regulatorische Audits.
Warum wird die asynchrone Verarbeitung für die Datenvorbereitung bei KI-Sprachassistenten im großen Maßstab bevorzugt?
Die asynchrone Verarbeitung ermöglicht es Engineering-Teams, große Datensätze mittels Stapeldatei-Übermittlungen zu bewerten, ohne Latenzzeiten bei Echtzeitanrufen einzuführen. Systeme können Listen als TXT- oder CSV-Dateien mit einer Nummer pro Zeile hochladen, um Netzwerk- und Aktivierungserkenntnisse offline zu generieren. Diese Entkopplung isoliert Datenhygiene-Workflows von der kundenorientierten Telefonie-Infrastruktur und unterstützt die operative Effizienz.
Welche Rolle spielt die Datenminimierung bei der Architektur von KI-Sprachassistenten?
Datenminimierung erfordert das Erheben und Verarbeiten nur der Daten, die für eine spezifische Interaktion unbedingt erforderlich sind. In Architekturen für Sprachassistenten reduziert die Verwendung leichtgewichtiger operativer Signale – wie Aktivierungsstatus oder Netzbetreiber-Kontext – anstatt der Speicherung sensibler persönlicher Identifikatoren die Risiken der Datenexposition und hilft bei der Erfüllung gesetzlicher Verpflichtungen unter Rahmenwerken wie der GDPR.
Mehr erfahren
Wählen Sie die Produktinformationen, die zum nächsten Schritt in Ihrem Arbeitsablauf passen.