Guía de producto
Más allá de la validación: cómo construir una base de datos unificada para una identidad de cliente preparada para la IA
Descubra cómo una infraestructura de datos de clientes para la verificación de identidad ayuda a combatir la amnesia del agente y prepara los contactos para flujos de IA.
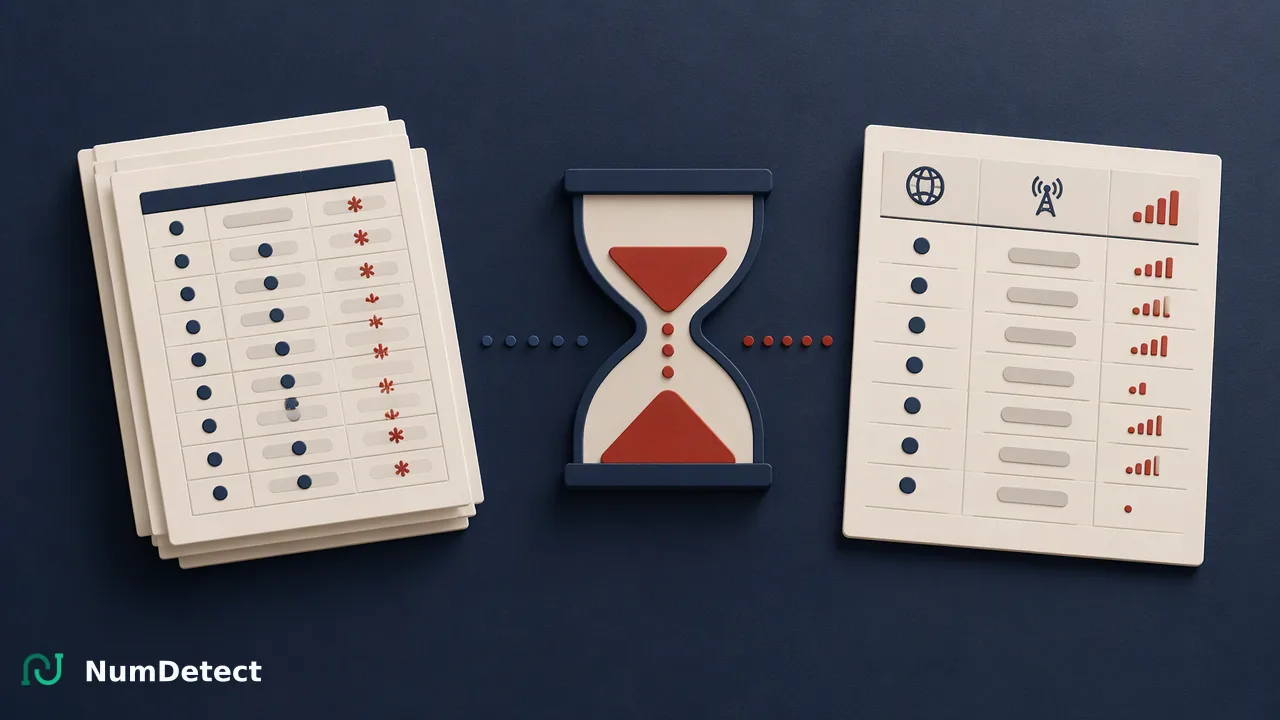
Descubra por qué los agentes de IA fallan sin una base de datos unificada, cómo afecta la amnesia del agente a las operaciones y cómo la higiene masiva y asíncrona de datos telefónicos respalda flujos de atención al cliente fiables.
Construir una infraestructura de datos de clientes eficaz para la verificación de identidad exige que las organizaciones depuren, normalicen y verifiquen grandes conjuntos de datos de contacto antes de introducirlos en sistemas automatizados. Cuando los agentes de inteligencia artificial trabajan con registros fragmentados u obsoletos, sufren la amnesia del agente (Agent Amnesia): pierden una y otra vez el contexto de las interacciones y elevan los costes operativos. La infraestructura de datos moderna aborda este reto desacoplando las pesadas canalizaciones de verificación de los entornos de ejecución conversacionales. Mediante la higiene masiva y asíncrona de listas, los equipos evalúan señales de activación, atributos del operador y señales de actividad en directorios completos. Esta preparación estructurada ayuda a las organizaciones a mantener la continuidad del contexto, marcar los registros de contacto obsoletos y respaldar flujos automatizados fiables sin introducir cuellos de botella operativos en tiempo real.
La paradoja de la IA: herramientas más inteligentes, experiencias fragmentadas
Las empresas modernas despliegan agentes conversacionales para agilizar las interacciones; sin embargo, las herramientas sofisticadas suelen fallar cuando los datos del backend siguen fragmentados en silos desconectados. Cuando los sistemas automatizados consultan bases de datos dispares que carecen de identificadores unificados, sufren la amnesia del agente: un estado de fallo en el que un agente automatizado no puede relacionar las interacciones actuales con los registros históricos. En lugar de ofrecer una asistencia coherente, los sistemas desconectados obligan a los usuarios a repetir información básica o desvían el contacto por completo. A medida que las organizaciones escalan los flujos autónomos, la inteligencia depende en gran medida de la integridad de los datos. Una infraestructura de datos de clientes fiable para la verificación de identidad salva estas brechas anclando los perfiles de clientes a señales de comunicación verificadas. Al validar los registros de contacto antes de que los sistemas los incorporen, las organizaciones establecen un contexto continuo en todos los puntos de contacto, lo que ayuda a los motores automatizados a consultar atributos coherentes y actualizados en lugar de hacer conjeturas a partir de entradas de directorio obsoletas.
El coste de unos datos de identidad incompletos
Ejecutar flujos automatizados sobre conjuntos de datos no verificados genera una fricción considerable y un desperdicio de recursos. Los números de teléfono incompletos o no válidos provocan notificaciones fallidas, errores de enrutamiento y ciclos de procesamiento desperdiciados en las colas de comunicación automatizadas. Cuando los registros contienen números desactivados o asignaciones regionales incorrectas, las herramientas automatizadas consumen presupuesto de cómputo en intentos de contacto que no pueden prosperar. Más allá del coste de la mensajería, los conjuntos de datos desconectados deterioran la confianza de los clientes. Obligar a los usuarios a volver a autenticarse o a explicar de nuevo el contexto durante las sesiones automatizadas crea una fricción que reduce el valor de la automatización digital. Además, los equipos internos pierden visibilidad cuando varios departamentos mantienen atributos de contacto contradictorios para el mismo usuario. Sin una verificación sistemática, los registros del CRM acumulan entradas no válidas con el tiempo. Establecer canalizaciones proactivas de revisión de datos ayuda a los equipos a identificar pronto las entradas no válidas, lo que favorece bases de datos más limpias, reduce los costes de transmisión posteriores y preserva la confianza de los clientes durante las interacciones automatizadas.
Construir una base de datos unificada
Pasar de directorios estáticos a una base preparada para la IA requiere mecanismos de verificación escalables diseñados para procesar listas amplias. En lugar de intentar comprobaciones en línea durante las interacciones con los clientes, las operaciones de gran volumen se benefician de una arquitectura de tareas sobre archivos asíncrona. Plataformas como NumDetect ofrecen flujos asíncronos de información masiva sobre números de teléfono que gestionan la higiene de directorios a gran escala de forma independiente de los entornos de ejecución de los agentes activos. Los equipos envían conjuntos de datos con entre 500 y 500,000 números de teléfono válidos en un archivo TXT o CSV estándar, junto con un código ISO de país designado, mediante POST /api/v1/bulk-tasks. Como estas tareas masivas se ejecutan de forma asíncrona, las organizaciones evitan picos de latencia en las herramientas operativas mientras procesan grandes conjuntos de datos. Las consultas de estado mediante GET /api/v1/bulk-tasks/{id} informan del progreso del procesamiento a través de estados públicos claros: processing, success y failed. Tenga en cuenta que los números de China continental no se admiten en este flujo masivo. Esta infraestructura desacoplada garantiza que las bases de datos del CRM reciban actualizaciones periódicas y estructuradas sin afectar a la capacidad de respuesta de los agentes en tiempo de ejecución.
Poner en práctica la higiene de datos para preparar la IA
Preparar listas de contactos para flujos autónomos implica evaluar varias señales independientes en lugar de basarse solo en la validación básica del formato. NumDetect ofrece señales especializadas que ayudan a los equipos a clasificar los registros de forma eficaz:
- Consulta global de operadores: aporta el contexto del operador para orientar las decisiones de enrutamiento y la segmentación; funciona como una revisión de atributos de red, no como una consulta del abonado.
- Actividad del número: devuelve una señal de actividad útil para clasificar y segmentar audiencias, sin informar de marcas de tiempo concretas ni de métricas de frecuencia.
- Usuarios de alto valor y E-commerce activo: ofrecen señales contextuales que reflejan atributos de red y actividad en el comercio electrónico, y sirven como indicadores de apoyo a la decisión, no como registros financieros ni de transacciones.
Aplicar estas señales diferenciadas de forma asíncrona ayuda a los equipos técnicos a priorizar los contactos receptivos, estructurar el enrutamiento regional y mejorar la eficiencia de los agentes de IA.
Preguntas frecuentes
¿Por qué la interacción con clientes impulsada por IA requiere una base de datos unificada?
Los sistemas de IA necesitan registros subyacentes precisos para mantener la continuidad del contexto en los distintos puntos de contacto con el cliente. Trabajar con datos fragmentados o no verificados provoca la amnesia del agente: los agentes pierden el contexto, piden a los clientes datos redundantes o desencadenan comunicaciones que no pueden entregarse. Integrar una infraestructura de datos de clientes verificada para la verificación de identidad ayuda a garantizar que los sistemas consulten identificadores limpios y activos, lo que contribuye a reducir el desperdicio operativo y favorece interacciones automatizadas más fluidas en todos los canales.
¿Cómo mejora el procesamiento masivo asíncrono la calidad de los datos para la IA?
El procesamiento masivo asíncrono ayuda a los equipos a revisar y depurar listas de contactos extensas —de 500 a 500,000 números por tarea— sin sobrecargar los sistemas conversacionales en producción. Al enviar archivos estructurados mediante endpoints de API y consultar el estado de los trabajos de forma asíncrona, las organizaciones enriquecen sus CRM con señales de activación y de operador en ejecuciones programadas. Esta preparación en segundo plano proporciona datos fiables para los flujos automatizados y evita la latencia durante las conversaciones en vivo con los clientes.
¿Qué es la amnesia del agente y cómo pueden abordarla las organizaciones?
La amnesia del agente describe la incapacidad de un sistema de IA para conservar el contexto entre sesiones de clientes debido a datos de backend fragmentados o aislados en silos. Las organizaciones la abordan implantando prácticas unificadas de higiene de datos. Validar periódicamente las listas de teléfonos, confirmar las señales de activación y enriquecer los registros con el contexto del operador ayuda a garantizar que los agentes automatizados accedan a perfiles de clientes sincronizados, lo que favorece la continuidad y reduce las interacciones repetitivas e inconexas.
Más información
Elija la información de producto que se ajuste al siguiente paso de su flujo de trabajo.