Ürün rehberi
Doğrulamanın Ötesinde: Yapay Zekâya Hazır Müşteri Kimliği için Birleşik Bir Veri Temeli Oluşturmak
Kimlik doğrulama için müşteri verisi altyapısının Ajan Amnezisi sorununu nasıl ele aldığını ve kişi veri kümelerini otomatik yapay zekâ iş akışlarına nasıl hazırladığını öğrenin.
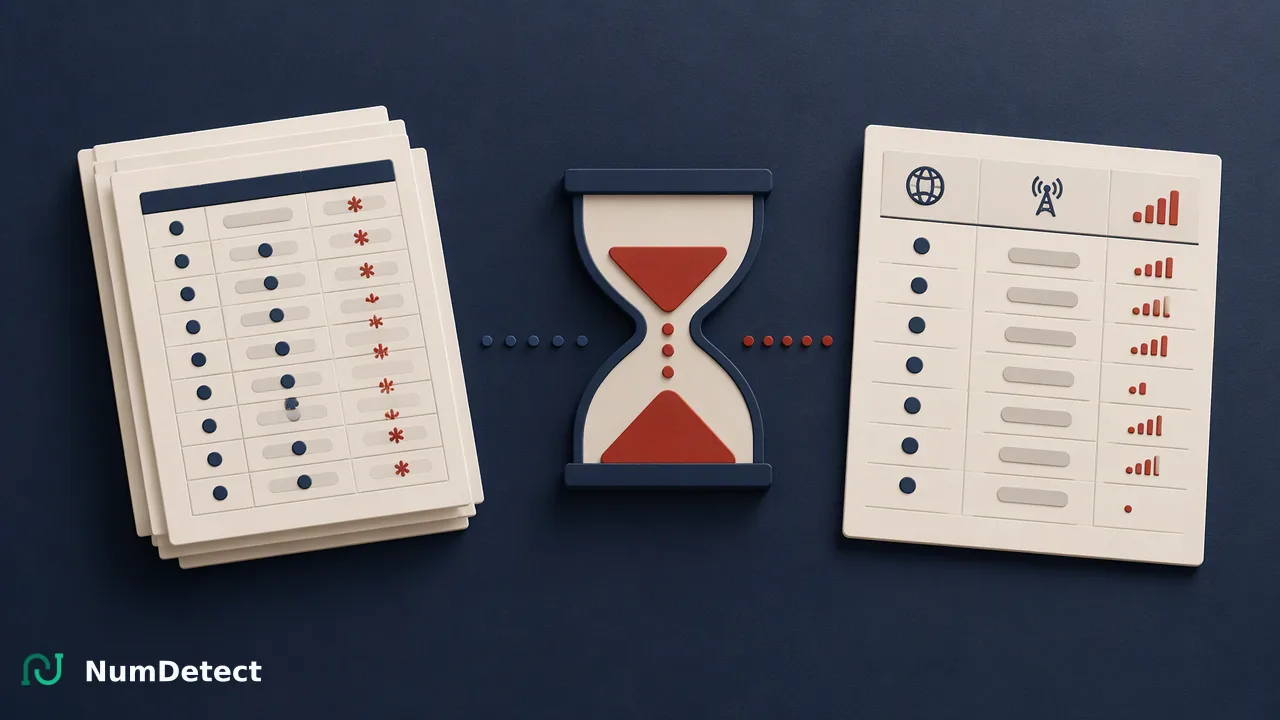
Yapay zekâ ajanlarının birleşik bir veri temeli olmadan neden başarısız olduğunu, Ajan Amnezisinin operasyonları nasıl etkilediğini ve asenkron toplu telefon verisi hijyeninin güvenilir müşteri iş akışlarını nasıl desteklediğini keşfedin.
Kimlik doğrulama için etkili bir müşteri verisi altyapısı oluşturmak, kuruluşların büyük kişi veri kümelerini otomatik sistemlere aktarmadan önce temizlemesini, normalleştirmesini ve doğrulamasını gerektirir. Yapay zekâ ajanları parçalı veya eskimiş kayıtlar üzerinde çalıştığında Ajan Amnezisi (Agent Amnesia) ile karşılaşır; etkileşim bağlamını tekrar tekrar kaybeder ve operasyonel yükü artırır. Modern veri altyapısı, ağır doğrulama süreçlerini konuşma çalışma zamanlarından ayırarak bu sorunun üstesinden gelir. Ekipler asenkron toplu liste hijyeni sayesinde tüm dizinlerde aktivasyon sinyallerini, operatör özniteliklerini ve etkinlik sinyallerini değerlendirir. Bu yapılandırılmış hazırlık, kuruluşların gerçek zamanlı operasyonel darboğazlar yaratmadan bağlamsal sürekliliği korumasına, eskimiş kişi kayıtlarını işaretlemesine ve güvenilir otomatik iş akışlarını desteklemesine yardımcı olur.
Yapay Zekâ Paradoksu: Daha Akıllı Araçlar, Parçalı Deneyimler
Modern işletmeler etkileşimleri kolaylaştırmak için konuşma ajanları kullanır; ancak gelişmiş araçlar, arka uç verileri birbirinden kopuk silolara dağılmış kaldığında çoğu zaman başarısız olur. Otomatik sistemler birleşik tanımlayıcılardan yoksun, dağınık veritabanlarını sorguladığında Ajan Amnezisi yaşar: otomatik bir ajanın mevcut etkileşimleri geçmiş kayıtlarla ilişkilendiremediği bir hata durumu. Kopuk sistemler tutarlı bir yardım sunmak yerine kullanıcıları temel bilgileri tekrarlamaya zorlar veya erişimi tamamen yanlış yöne yönlendirir. Kuruluşlar özerk iş akışlarını ölçeklendirdikçe zekâ büyük ölçüde veri bütünlüğüne bağlı hâle gelir. Kimlik doğrulama için güvenilir bir müşteri verisi altyapısı, müşteri profillerini doğrulanmış iletişim sinyallerine bağlayarak bu boşlukları kapatır. Kuruluşlar kişi kayıtlarını sistemler onları almadan önce doğrulayarak temas noktaları arasında sürekli bir bağlam oluşturur; bu da otomatik motorların eskimiş dizin girdileri üzerinden tahmin yürütmek yerine tutarlı ve güncel özniteliklere başvurmasına yardımcı olur.
Eksik Kimlik Verisinin Maliyeti
Otomatik iş akışlarını doğrulanmamış veri kümeleri üzerinde çalıştırmak ciddi sürtünmeye ve kaynak israfına yol açar. Eksik veya geçersiz telefon numaraları; başarısız bildirimlere, yönlendirme hatalarına ve otomatik iletişim kuyruklarında boşa harcanan işlem döngülerine neden olur. Kayıtlar devre dışı bırakılmış numaralar veya hatalı bölgesel atamalar içerdiğinde otomatik araçlar, başarılı olamayacak erişim denemelerine hesaplama bütçesi harcar. Mesajlaşma yükünün ötesinde kopuk veri kümeleri müşteri güvenini de zedeler. Kullanıcıları otomatik oturumlar sırasında yeniden kimlik doğrulamaya veya bağlamı yeniden açıklamaya zorlamak, dijital otomasyonun değerini azaltan bir sürtünme yaratır. Ayrıca birden fazla departman aynı kullanıcı için çelişkili kişi öznitelikleri tuttuğunda dahili ekipler görünürlüğü kaybeder. Sistematik doğrulama olmadan CRM kayıtlarında zamanla geçersiz girdiler birikir. Proaktif veri inceleme süreçleri kurmak, ekiplerin geçersiz girdileri erken belirlemesine yardımcı olur; daha temiz veritabanlarını destekler, sonraki iletim maliyetlerini azaltır ve otomatik etkileşimler sırasında müşteri güvenini korur.
Birleşik Bir Veri Temeli Oluşturmak
Statik dizinlerden yapay zekâya hazır bir temele geçiş, geniş kapsamlı liste işleme için tasarlanmış ölçeklenebilir doğrulama mekanizmaları gerektirir. Yüksek hacimli operasyonlar, müşteriyle doğrudan etkileşimler sırasında satır içi kontroller yapmaya çalışmak yerine asenkron bir dosya görevi mimarisinden fayda sağlar. NumDetect gibi platformlar, büyük ölçekli dizin hijyenini etkin ajan çalışma zamanlarından bağımsız olarak yürüten asenkron toplu telefon numarası içgörü iş akışları sunar. Ekipler, 500 ile 500.000 arasında geçerli telefon numarası içeren veri kümelerini standart bir TXT veya CSV dosyası ve belirlenmiş bir ISO ülke koduyla birlikte POST /api/v1/bulk-tasks üzerinden gönderir. Bu toplu görevler asenkron çalıştığından kuruluşlar büyük veri kümelerini işlerken operasyonel araçlarda gecikme sıçramalarından kaçınır. GET /api/v1/bulk-tasks/{id} üzerinden yapılan durum kontrolleri, işleme ilerlemesini net genel durumlarla bildirir: işleniyor, başarılı ve başarısız. Çin anakarası numaralarının bu toplu iş akışında desteklenmediğini unutmayın. Bu ayrıştırılmış altyapı, CRM veritabanlarının çalışma zamanındaki ajan yanıt hızını etkilemeden düzenli ve yapılandırılmış güncellemeler almasını sağlar.
Yapay Zekâya Hazırlık için Veri Hijyenini Operasyonel Hâle Getirmek
Kişi listelerini özerk iş akışlarına hazırlamak, yalnızca temel biçim doğrulamasına dayanmak yerine birden fazla bağımsız sinyali değerlendirmeyi içerir. NumDetect, ekiplerin kayıtları etkili biçimde sınıflandırmasına yardımcı olan özelleşmiş sinyaller sunar:
- Küresel operatör sorgulama: Yönlendirme kararlarına ve segmentasyona bilgi sağlamak için operatör bağlamı sunar; bir abone sorgulaması değil, bir şebeke özniteliği incelemesi olarak işlev görür.
- Numara Etkinliği: Belirli zaman damgalarını veya sıklık ölçümlerini bildirmeden kitle sıralaması ve segmentasyon için yararlı bir etkinlik sinyali döndürür.
- Yüksek Değerli Kullanıcılar ve E-ticaret Etkinliği: Şebeke özniteliklerini ve e-ticaret etkileşimini yansıtan bağlamsal sinyaller sunar; finansal veya işlem kayıtları değil, karar destek göstergeleri olarak hizmet eder.
Bu farklı sinyalleri asenkron olarak uygulamak, teknik ekiplerin yanıt veren kişileri önceliklendirmesini, bölgesel yönlendirmeyi yapılandırmasını ve yapay zekâ ajanlarının verimliliğine katkıda bulunmasını destekler.
SSS
Yapay zekâ destekli müşteri etkileşimi neden birleşik bir veri temeli gerektirir?
Yapay zekâ sistemleri, birden fazla müşteri temas noktasında bağlamsal sürekliliği korumak için doğru temel kayıtlara ihtiyaç duyar. Parçalı veya doğrulanmamış veriler üzerinde çalışmak Ajan Amnezisine yol açar; ajanlar bağlamı kaybeder, müşterilerden gereksiz yere veri ister veya teslim edilemeyen iletişimleri tetikler. Kimlik doğrulama için doğrulanmış bir müşteri verisi altyapısını entegre etmek, sistemlerin temiz ve etkin tanımlayıcılara başvurmasını sağlamaya yardımcı olur; bu da operasyonel israfı azaltmaya yardımcı olur ve kanallar arasında daha sorunsuz otomatik etkileşimleri destekler.
Asenkron toplu işleme yapay zekâ için veri kalitesini nasıl iyileştirir?
Asenkron toplu işleme, ekiplerin canlı konuşma sistemlerini aşırı yüklemeden görev başına 500 ile 500.000 numara arasında değişen kapsamlı kişi listelerini incelemesine ve temizlemesine yardımcı olur. Kuruluşlar yapılandırılmış dosyaları API uç noktaları üzerinden gönderip iş durumlarını asenkron olarak kontrol ederek CRM'lerini planlanmış çalıştırmalarda aktivasyon ve operatör sinyalleriyle zenginleştirir. Bu arka plan hazırlığı, canlı müşteri görüşmeleri sırasında gecikmeyi önlerken otomatik iş akışları için güvenilir bir veri hazırlığı sağlar.
Ajan Amnezisi nedir ve kuruluşlar bunu nasıl ele alabilir?
Ajan Amnezisi, bir yapay zekâ sisteminin parçalı veya silolara ayrılmış arka uç verileri nedeniyle müşteri oturumları arasında bağlamı koruyamamasını tanımlar. Kuruluşlar bu sorunu birleşik veri hijyeni uygulamaları hayata geçirerek ele alır. Telefon listelerini düzenli olarak doğrulamak, aktivasyon sinyallerini teyit etmek ve kayıtları operatör bağlamıyla zenginleştirmek, otomatik ajanların senkronize müşteri profillerine erişmesini sağlamaya yardımcı olur; sürekliliği destekler ve tekrarlayan, kopuk etkileşimleri azaltır.
Daha Fazla Bilgi
İş akışınızdaki bir sonraki adıma uygun ürün bilgisini seçin.