Produktleitfaden
Mehr als Validierung: Eine einheitliche Datengrundlage für KI-fähige Kundenidentitäten aufbauen
Erfahren Sie, wie eine Kundendateninfrastruktur für die Identitätsprüfung gegen Agent-Amnesie hilft und Kontaktdatenbestände für automatisierte KI-Workflows vorbereitet.
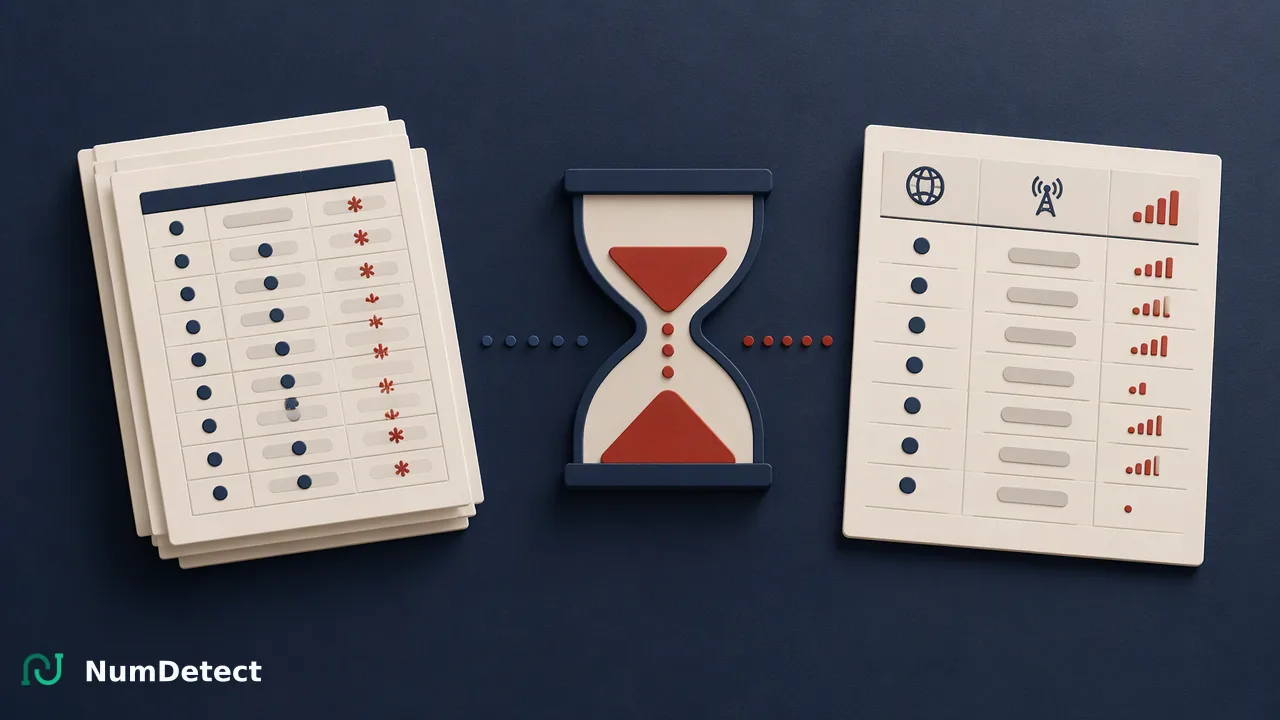
Erfahren Sie, warum KI-Agenten ohne einheitliche Datengrundlage scheitern, wie sich Agent-Amnesie auf den Betrieb auswirkt und wie eine asynchrone Massenpflege von Telefondaten zuverlässige Kunden-Workflows unterstützt.
Eine wirksame Kundendateninfrastruktur für die Identitätsprüfung verlangt von Organisationen, große Kontaktdatenbestände zu bereinigen, zu normalisieren und zu prüfen, bevor sie in automatisierte Systeme eingespeist werden. Arbeiten KI-Agenten mit fragmentierten oder veralteten Datensätzen, geraten sie in einen Zustand der Agent-Amnesie: Sie verlieren immer wieder den Interaktionskontext und treiben den betrieblichen Aufwand in die Höhe. Moderne Dateninfrastruktur begegnet dieser Herausforderung, indem sie aufwendige Prüfpipelines von den Laufzeitumgebungen der Dialogsysteme entkoppelt. Mit einer asynchronen Massenpflege von Listen werten Teams Aktivierungssignale, Netzbetreibermerkmale und Aktivitätssignale für ganze Verzeichnisse aus. Diese strukturierte Vorbereitung hilft Organisationen, die Kontextkontinuität zu wahren, veraltete Kontaktdatensätze zu kennzeichnen und zuverlässige automatisierte Workflows zu unterstützen, ohne Engpässe im Echtzeitbetrieb zu erzeugen.
Das KI-Paradox: Klügere Werkzeuge, fragmentierte Erlebnisse
Moderne Unternehmen setzen dialogfähige Agenten ein, um Interaktionen zu vereinfachen – doch selbst ausgefeilte Werkzeuge scheitern oft, wenn die Backend-Daten auf voneinander getrennte Silos verteilt sind. Fragen automatisierte Systeme unterschiedliche Datenbanken ohne einheitliche Kennungen ab, leiden sie unter Agent-Amnesie – einem Fehlerzustand, in dem ein automatisierter Agent aktuelle Interaktionen nicht mit historischen Datensätzen verknüpfen kann. Statt zusammenhängende Unterstützung zu bieten, zwingen getrennte Systeme Nutzer, grundlegende Informationen zu wiederholen, oder leiten die Kontaktaufnahme ganz fehl. Wenn Organisationen autonome Workflows ausbauen, hängt die Intelligenz stark von der Datenintegrität ab. Eine zuverlässige Kundendateninfrastruktur für die Identitätsprüfung schließt diese Lücken, indem sie Kundenprofile an geprüften Kommunikationssignalen verankert. Werden Kontaktdatensätze geprüft, bevor Systeme sie übernehmen, schaffen Organisationen durchgängigen Kontext über alle Kontaktpunkte hinweg und helfen automatisierten Systemen, sich auf konsistente, aktuelle Merkmale zu stützen, statt anhand veralteter Verzeichniseinträge zu raten.
Die Kosten unvollständiger Identitätsdaten
Automatisierte Workflows auf ungeprüften Datenbeständen zu betreiben, verursacht erhebliche Reibung und Ressourcenverschwendung. Unvollständige oder ungültige Telefonnummern führen zu fehlgeschlagenen Benachrichtigungen, Routing-Fehlern und verschwendeten Verarbeitungszyklen in automatisierten Kommunikationswarteschlangen. Enthalten Datensätze deaktivierte Nummern oder falsche regionale Zuordnungen, verbrauchen automatisierte Werkzeuge Rechenbudget für Kontaktversuche, die nicht gelingen können. Über den Messaging-Aufwand hinaus untergraben getrennte Datenbestände das Vertrauen der Kunden. Müssen sich Nutzer während automatisierter Sitzungen erneut authentifizieren oder den Kontext erneut erklären, entsteht Reibung, die den Wert der digitalen Automatisierung schmälert. Zudem verlieren interne Teams den Überblick, wenn mehrere Abteilungen widersprüchliche Kontaktmerkmale für denselben Nutzer pflegen. Ohne systematische Prüfung sammeln CRM-Datensätze mit der Zeit ungültige Einträge an. Vorausschauende Pipelines zur Datenprüfung helfen Teams, ungültige Einträge früh zu erkennen – für sauberere Datenbanken, geringere nachgelagerte Übertragungskosten und anhaltendes Kundenvertrauen bei automatisierten Interaktionen.
Eine einheitliche Datengrundlage aufbauen
Der Übergang von statischen Verzeichnissen zu einer KI-fähigen Grundlage erfordert skalierbare Prüfmechanismen, die für die Verarbeitung umfangreicher Listen ausgelegt sind. Statt Inline-Prüfungen während kundenseitiger Interaktionen zu versuchen, profitieren großvolumige Abläufe von einer asynchronen Architektur mit Dateiaufgaben. Plattformen wie NumDetect bieten asynchrone Workflows für Masseneinblicke in Telefonnummern, die die Pflege großer Verzeichnisse unabhängig von den aktiven Laufzeitumgebungen der Agenten übernehmen. Teams übermitteln Datenbestände mit 500 bis 500.000 gültigen Telefonnummern als standardmäßige TXT- oder CSV-Datei zusammen mit einem festgelegten ISO-Ländercode über POST /api/v1/bulk-tasks. Da diese Massenaufgaben asynchron laufen, vermeiden Organisationen Latenzspitzen in operativen Werkzeugen, während große Datenbestände verarbeitet werden. Statusabfragen über GET /api/v1/bulk-tasks/{id} melden den Verarbeitungsfortschritt über klare öffentliche Status: „in Verarbeitung“, „erfolgreich“ und „fehlgeschlagen“. Beachten Sie, dass Nummern aus Festlandchina in diesem Massen-Workflow nicht unterstützt werden. Diese entkoppelte Infrastruktur stellt sicher, dass CRM-Datenbanken regelmäßige, strukturierte Aktualisierungen erhalten, ohne die Reaktionsfähigkeit der Agenten zur Laufzeit zu beeinträchtigen.
Datenpflege für KI-Bereitschaft operativ umsetzen
Die Vorbereitung von Kontaktlisten für autonome Workflows umfasst die Auswertung mehrerer unabhängiger Signale, statt sich allein auf eine einfache Formatvalidierung zu verlassen. NumDetect bietet spezialisierte Signale, mit denen Teams Datensätze wirksam einordnen können:
- Globale Netzbetreiberabfrage: Liefert Netzbetreiberkontext als Grundlage für Routing-Entscheidungen und Segmentierung und dient als Prüfung von Netzmerkmalen, nicht als Teilnehmerabfrage.
- Nummernaktivität: Liefert ein Aktivitätssignal, das sich für die Einstufung und Segmentierung von Zielgruppen eignet, ohne konkrete Zeitstempel oder Häufigkeitskennzahlen auszuweisen.
- High-Value-Nutzer & E-Commerce-Aktivität: Bieten kontextbezogene Signale zu Netzmerkmalen und E-Commerce-Engagement und dienen als Indikatoren zur Entscheidungsunterstützung, nicht als Finanz- oder Transaktionsdaten.
Die asynchrone Anwendung dieser eigenständigen Signale unterstützt technische Teams dabei, reaktionsfreudige Kontakte zu priorisieren, regionales Routing zu strukturieren und die Effizienz von KI-Agenten zu fördern.
FAQ
Warum erfordert KI-gestützte Kundenbindung eine einheitliche Datengrundlage?
KI-Systeme benötigen genaue zugrunde liegende Datensätze, um die Kontextkontinuität über mehrere Kundenkontaktpunkte hinweg zu wahren. Die Arbeit mit fragmentierten oder ungeprüften Daten verursacht Agent-Amnesie: Agenten verlieren den Kontext, fragen Kunden nach redundanten Daten oder lösen nicht zustellbare Kommunikation aus. Die Einbindung einer geprüften Kundendateninfrastruktur für die Identitätsprüfung hilft sicherzustellen, dass Systeme auf saubere, aktive Kennungen zugreifen. Das reduziert betriebliche Verschwendung und unterstützt reibungslosere automatisierte Interaktionen über alle Kanäle hinweg.
Wie verbessert asynchrone Massenverarbeitung die Datenqualität für KI?
Asynchrone Massenverarbeitung hilft Teams, umfangreiche Kontaktlisten – mit 500 bis 500.000 Nummern pro Aufgabe – zu prüfen und zu bereinigen, ohne Live-Dialogsysteme zu überlasten. Durch das Übermitteln strukturierter Dateien über API-Endpunkte und die asynchrone Abfrage des Auftragsstatus reichern Organisationen ihre CRMs in geplanten Läufen mit Aktivierungs- und Netzbetreibersignalen an. Diese Vorbereitung im Hintergrund sorgt für zuverlässige Datenbereitschaft für automatisierte Workflows und vermeidet Latenz während Live-Kundengesprächen.
Was ist Agent-Amnesie und wie können Organisationen ihr begegnen?
Agent-Amnesie beschreibt die Unfähigkeit eines KI-Systems, Kontext über Kundensitzungen hinweg zu behalten, weil die Backend-Daten fragmentiert oder in Silos verteilt sind. Organisationen begegnen dem durch einheitliche Praktiken der Datenpflege. Telefonlisten regelmäßig zu validieren, Aktivierungssignale zu bestätigen und Datensätze um Netzbetreiberkontext anzureichern, hilft sicherzustellen, dass automatisierte Agenten auf synchronisierte Kundenprofile zugreifen – für anhaltende Kontinuität und weniger wiederholte, unzusammenhängende Interaktionen.
Mehr erfahren
Wählen Sie die Produktinformationen, die zum nächsten Schritt in Ihrem Workflow passen.