Руководство по продукту
Больше чем валидация: единая основа данных для клиентской идентификации, готовой к ИИ
Как инфраструктура клиентских данных для проверки личности помогает бороться с «амнезией агента» и готовит базы контактов к автоматизированным процессам ИИ.
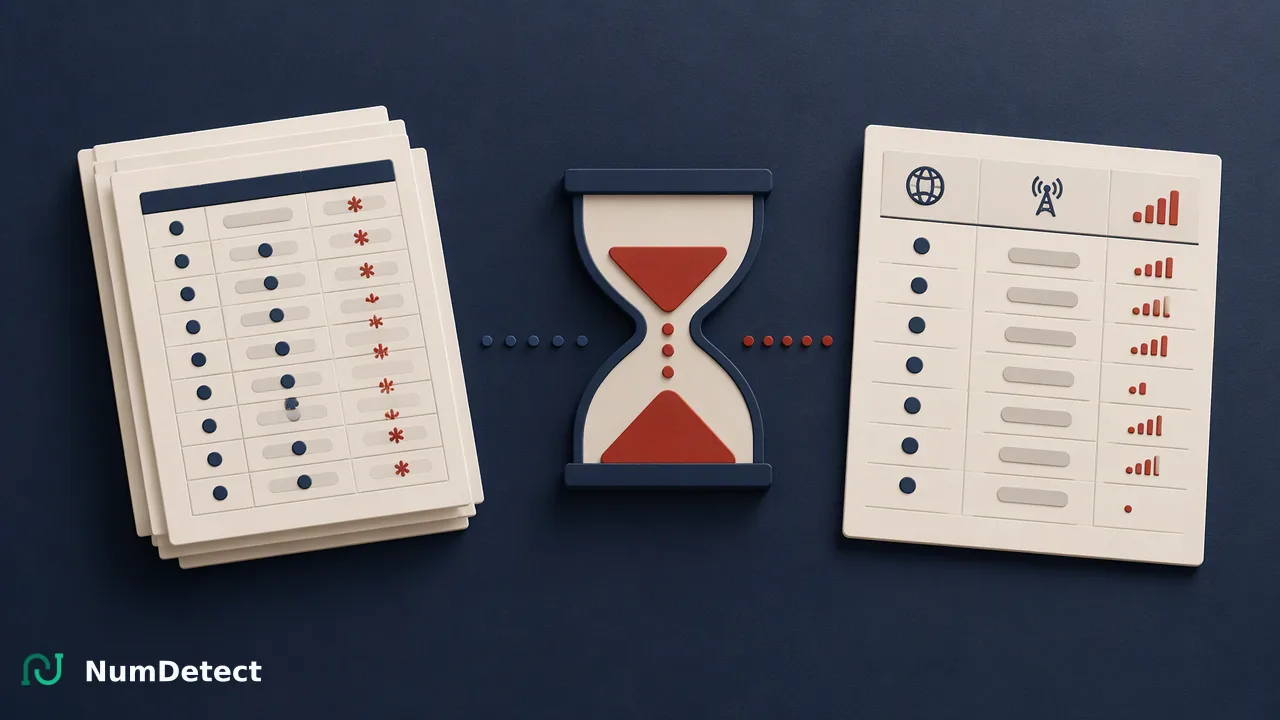
Почему ИИ-агенты не справляются без единой основы данных, как «амнезия агента» влияет на операционную деятельность и как асинхронная массовая гигиена телефонных данных поддерживает надежные клиентские процессы.
Чтобы построить эффективную инфраструктуру клиентских данных для проверки личности, организациям нужно очищать, нормализовать и проверять большие наборы контактных данных до того, как передавать их в автоматизированные системы. Когда агенты искусственного интеллекта работают с фрагментированными или устаревшими записями, они сталкиваются с «амнезией агента» — раз за разом теряют контекст взаимодействия, увеличивая операционные издержки. Современная инфраструктура данных решает эту проблему, отделяя ресурсоемкие конвейеры проверки от сред выполнения диалогов. Благодаря асинхронной массовой гигиене списков команды оценивают сигналы активации, атрибуты оператора и сигналы активности по всем справочникам. Такая структурированная подготовка помогает организациям сохранять непрерывность контекста, выявлять устаревшие контактные записи и поддерживать надежные автоматизированные процессы, не создавая узких мест в реальном времени.
Парадокс ИИ: инструменты умнее, а опыт фрагментирован
Современные предприятия внедряют диалоговых агентов, чтобы упростить взаимодействие, однако даже продвинутые инструменты часто не справляются, когда данные на стороне сервера остаются разрозненными по изолированным хранилищам. Когда автоматизированные системы обращаются к разрозненным базам данных без единых идентификаторов, они страдают от «амнезии агента» — состояния сбоя, при котором автоматизированный агент не может связать текущее взаимодействие с историческими записями. Вместо целостной помощи разрозненные системы заставляют пользователей повторять базовую информацию или вовсе направляют коммуникации не по адресу. По мере масштабирования автономных процессов их интеллектуальность все больше зависит от целостности данных. Надежная инфраструктура клиентских данных для проверки личности устраняет эти разрывы, привязывая профили клиентов к проверенным сигналам связи. Проверяя контактные записи до их загрузки в системы, организации обеспечивают непрерывность контекста во всех точках взаимодействия, помогая автоматизированным механизмам опираться на согласованные и актуальные атрибуты, а не на догадки по устаревшим записям справочников.
Цена неполных идентификационных данных
Работа автоматизированных процессов с непроверенными наборами данных создает значительные трудности и приводит к потере ресурсов. Неполные или недействительные номера телефонов ведут к неудачным уведомлениям, ошибкам маршрутизации и напрасно потраченным циклам обработки в автоматизированных очередях коммуникаций. Когда записи содержат деактивированные номера или неверные региональные привязки, автоматизированные инструменты расходуют вычислительный бюджет на рассылки, которые не могут быть успешными. Помимо издержек на сообщения, разрозненные наборы данных подрывают доверие клиентов. Необходимость заново проходить аутентификацию или повторно объяснять контекст во время автоматизированных сеансов создает трудности, снижающие ценность цифровой автоматизации. Кроме того, внутренние команды теряют прозрачность, когда разные отделы хранят противоречивые контактные атрибуты одного и того же пользователя. Без систематической проверки записи CRM со временем накапливают недействительные данные. Проактивные конвейеры проверки данных помогают командам выявлять недействительные записи на раннем этапе, поддерживая чистоту баз данных, снижая последующие расходы на передачу и сохраняя доверие клиентов при автоматизированном взаимодействии.
Построение единой основы данных
Переход от статических справочников к основе, готовой к ИИ, требует масштабируемых механизмов проверки, рассчитанных на обработку больших списков. Вместо встроенных проверок во время взаимодействия с клиентом крупным операциям выгоднее асинхронная архитектура файловых задач. Такие платформы, как NumDetect, предоставляют процессы асинхронной массовой аналитики номеров телефонов, которые выполняют масштабную гигиену справочников независимо от активных сред выполнения агентов. Команды отправляют наборы данных, содержащие от 500 до 500 000 действительных номеров телефонов, в стандартном файле TXT или CSV вместе с назначенным кодом страны ISO через POST /api/v1/bulk-tasks. Поскольку эти массовые задачи выполняются асинхронно, организации избегают всплесков задержки в операционных инструментах при обработке больших наборов данных. Проверка статуса через GET /api/v1/bulk-tasks/{id} сообщает о ходе обработки с помощью четких публичных состояний: processing, success и failed. Обратите внимание, что номера материкового Китая в этом массовом процессе не поддерживаются. Такая развязанная инфраструктура обеспечивает регулярное структурированное обновление баз данных CRM, не влияя на скорость ответа агентов во время выполнения.
Внедрение гигиены данных для готовности к ИИ
Подготовка списков контактов к автономным процессам предполагает оценку нескольких независимых сигналов, а не только базовую проверку формата. NumDetect предлагает специализированные сигналы, которые помогают командам эффективно классифицировать записи:
- Глобальное определение оператора: предоставляет контекст оператора для решений о маршрутизации и сегментации и служит анализом сетевых атрибутов, а не поиском данных абонента.
- Активность номеров: возвращает сигнал активности, полезный для ранжирования и сегментации аудитории, без указания конкретных меток времени или показателей частоты.
- Ценные пользователи и Активность в e-commerce: дают контекстные сигналы, отражающие сетевые атрибуты и вовлеченность в электронную коммерцию, и служат показателями для поддержки решений, а не финансовыми записями или данными о транзакциях.
Асинхронное применение этих отдельных сигналов помогает техническим командам расставлять приоритеты для отзывчивых контактов, выстраивать региональную маршрутизацию и повышать эффективность ИИ-агентов.
Часто задаваемые вопросы
Почему взаимодействию с клиентами на основе ИИ нужна единая основа данных?
Системам ИИ нужны точные исходные записи, чтобы сохранять непрерывность контекста во множестве точек взаимодействия с клиентом. Работа с фрагментированными или непроверенными данными вызывает «амнезию агента»: агенты теряют контекст, повторно запрашивают у клиентов уже известные данные или запускают недоставляемые коммуникации. Интеграция проверенной инфраструктуры клиентских данных для проверки личности помогает системам опираться на чистые активные идентификаторы, что сокращает операционные потери и делает автоматизированное взаимодействие во всех каналах более плавным.
Как асинхронная массовая обработка повышает качество данных для ИИ?
Асинхронная массовая обработка помогает командам проверять и очищать обширные списки контактов — от 500 до 500 000 номеров на задачу — без перегрузки работающих диалоговых систем. Отправляя структурированные файлы через эндпоинты API и асинхронно проверяя статусы заданий, организации обогащают CRM сигналами активации и оператора в плановых запусках. Такая фоновая подготовка обеспечивает надежную готовность данных для автоматизированных процессов и позволяет избежать задержек во время живых разговоров с клиентами.
Что такое «амнезия агента» и как организации могут с ней справиться?
«Амнезия агента» — это неспособность системы ИИ сохранять контекст между сеансами с клиентом из-за фрагментированных или изолированных данных на стороне сервера. Организации решают эту проблему, внедряя единые практики гигиены данных. Регулярная проверка списков номеров, подтверждение сигналов активации и обогащение записей контекстом оператора помогают автоматизированным агентам обращаться к синхронизированным профилям клиентов, обеспечивая непрерывность и сокращая повторяющиеся, несвязные взаимодействия.
Узнать больше
Выберите информацию о продукте, которая подходит для следующего шага вашего процесса.