Orientação de produto
Além da validação: como construir uma base de dados unificada para uma identidade do cliente pronta para IA
Saiba como a infraestrutura de dados de clientes para verificação de identidade ajuda a combater a amnésia do agente e prepara contatos para fluxos automatizados de IA.
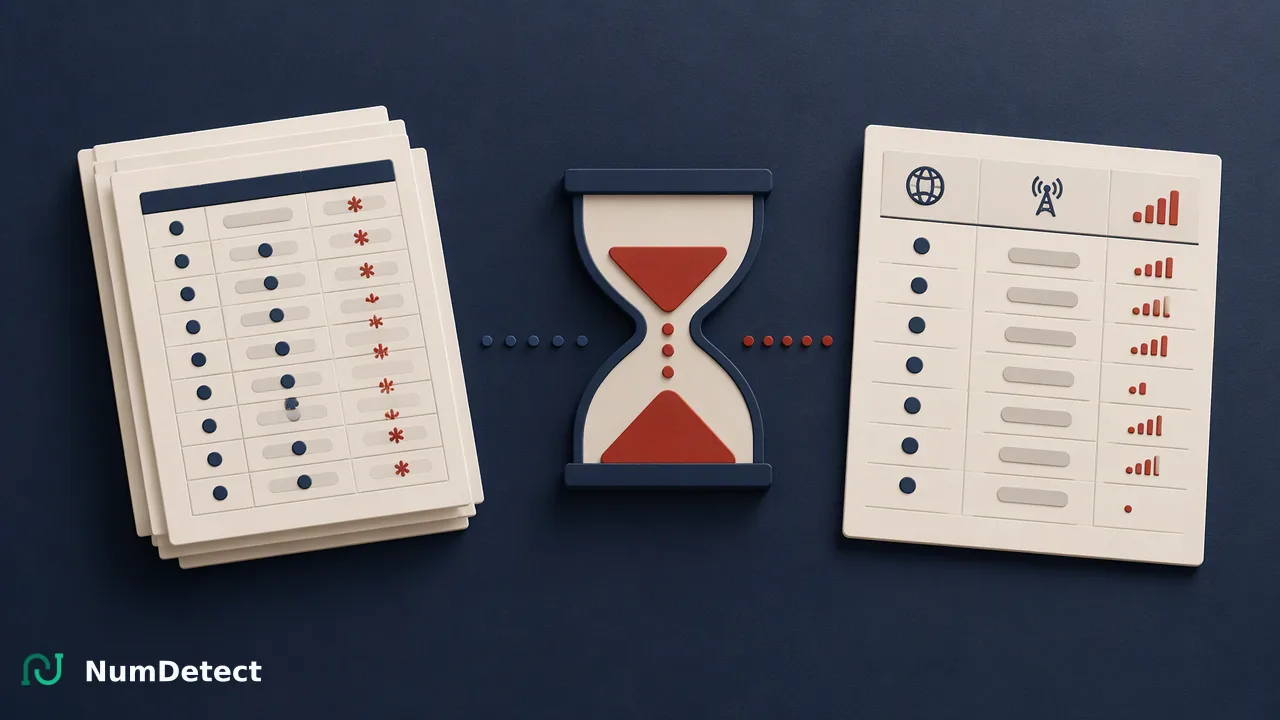
Descubra por que os agentes de IA falham sem uma base de dados unificada, como a amnésia do agente afeta as operações e como a higiene assíncrona em massa de dados telefônicos sustenta fluxos confiáveis de atendimento ao cliente.
Construir uma infraestrutura de dados de clientes eficaz para a verificação de identidade exige que as organizações limpem, normalizem e verifiquem grandes conjuntos de dados de contatos antes de alimentar os sistemas automatizados com eles. Quando agentes de inteligência artificial operam com registros fragmentados ou desatualizados, eles sofrem de amnésia do agente (Agent Amnesia): perdem repetidamente o contexto das interações e elevam os custos operacionais. A infraestrutura de dados moderna enfrenta esse desafio ao desacoplar os pipelines pesados de verificação dos ambientes de execução conversacionais. Com a higiene assíncrona de listas em massa, as equipes avaliam sinais de ativação, atributos de operadora e sinais de atividade em diretórios inteiros. Essa preparação estruturada ajuda as organizações a manter a continuidade do contexto, sinalizar registros de contato desatualizados e sustentar fluxos automatizados confiáveis sem introduzir gargalos operacionais em tempo real.
O paradoxo da IA: ferramentas mais inteligentes, experiências fragmentadas
As empresas modernas implantam agentes conversacionais para agilizar as interações, mas ferramentas sofisticadas muitas vezes falham quando os dados do backend continuam fragmentados em silos desconectados. Quando sistemas automatizados consultam bases de dados díspares sem identificadores unificados, eles sofrem de amnésia do agente — um estado de falha em que um agente automatizado não consegue relacionar as interações atuais aos registros históricos. Em vez de oferecer uma assistência coesa, sistemas desconectados obrigam os usuários a repetir informações básicas ou direcionam o contato para o lugar errado. À medida que as organizações ampliam os fluxos autônomos, a inteligência depende muito da integridade dos dados. Uma infraestrutura de dados de clientes confiável para a verificação de identidade preenche essas lacunas ao ancorar os perfis de clientes em sinais de comunicação verificados. Ao validar os registros de contato antes que os sistemas os ingiram, as organizações estabelecem um contexto contínuo entre os pontos de contato, ajudando os mecanismos automatizados a consultar atributos consistentes e atualizados em vez de tentar adivinhar com base em entradas de diretório desatualizadas.
O custo de dados de identidade incompletos
Executar fluxos automatizados com conjuntos de dados não verificados gera atritos consideráveis e desperdício de recursos. Números de telefone incompletos ou inválidos levam a notificações com falha, erros de roteamento e ciclos de processamento desperdiçados nas filas de comunicação automatizada. Quando os registros contêm números desativados ou atribuições regionais incorretas, as ferramentas automatizadas gastam orçamento computacional em tentativas de contato que não têm como dar certo. Além do custo das mensagens, conjuntos de dados desconectados corroem a confiança dos clientes. Obrigar os usuários a se autenticar novamente ou a explicar o contexto outra vez durante sessões automatizadas cria atritos que reduzem o valor da automação digital. Além disso, as equipes internas perdem visibilidade quando vários departamentos mantêm atributos de contato contraditórios para o mesmo usuário. Sem verificação sistemática, os registros do CRM acumulam entradas inválidas ao longo do tempo. Estabelecer pipelines proativos de revisão de dados ajuda as equipes a identificar entradas inválidas logo no início, contribuindo para bases de dados mais limpas, reduzindo os custos de transmissão posteriores e preservando a confiança dos clientes durante as interações automatizadas.
Construindo uma base de dados unificada
A transição de diretórios estáticos para uma base pronta para IA exige mecanismos de verificação escaláveis, projetados para o processamento de listas amplas. Em vez de tentar verificações em linha durante as interações com os clientes, operações de alto volume se beneficiam de uma arquitetura assíncrona de tarefas com arquivos. Plataformas como o NumDetect oferecem fluxos assíncronos de insights de números de telefone em massa que cuidam da higiene de diretórios em grande escala de forma independente dos ambientes de execução dos agentes ativos. As equipes enviam conjuntos de dados com 500 a 500.000 números de telefone válidos em um arquivo TXT ou CSV padrão, junto com um código ISO de país designado, via POST /api/v1/bulk-tasks. Como essas tarefas em massa são executadas de forma assíncrona, as organizações evitam picos de latência nas ferramentas operacionais enquanto processam grandes conjuntos de dados. As consultas de status via GET /api/v1/bulk-tasks/{id} informam o andamento do processamento por meio de estados públicos claros: processing, success e failed. Observe que números da China continental não são suportados neste fluxo em massa. Essa infraestrutura desacoplada garante que as bases de dados do CRM recebam atualizações regulares e estruturadas sem afetar a capacidade de resposta dos agentes em execução.
Colocando em prática a higiene de dados para a prontidão para IA
Preparar listas de contatos para fluxos autônomos envolve avaliar vários sinais independentes, em vez de depender apenas da validação básica de formato. O NumDetect oferece sinais especializados que ajudam as equipes a categorizar os registros com eficácia:
- Detecção Global de Operadora: fornece o contexto da operadora para orientar as decisões de roteamento e a segmentação, funcionando como uma revisão de atributos de rede, e não como uma consulta ao assinante.
- Atividade do Número: retorna um sinal de atividade útil para classificar e segmentar o público, sem informar horários específicos nem métricas de frequência.
- Usuários de Alto Valor e E-commerce Ativo: oferecem sinais contextuais que refletem atributos de rede e o engajamento com e-commerce, servindo como indicadores de apoio à decisão, e não como registros financeiros ou de transações.
Aplicar esses sinais distintos de forma assíncrona ajuda as equipes técnicas a priorizar os contatos responsivos, estruturar o roteamento regional e aumentar a eficiência dos agentes de IA.
Perguntas frequentes
Por que o engajamento de clientes orientado por IA exige uma base de dados unificada?
Os sistemas de IA precisam de registros subjacentes precisos para manter a continuidade do contexto em vários pontos de contato com o cliente. Operar com dados fragmentados ou não verificados causa amnésia do agente, situação em que os agentes perdem o contexto, pedem aos clientes dados redundantes ou disparam comunicações que não podem ser entregues. Integrar uma infraestrutura de dados de clientes verificada para a verificação de identidade ajuda a garantir que os sistemas consultem identificadores limpos e ativos, o que ajuda a reduzir o desperdício operacional e favorece interações automatizadas mais fluidas em todos os canais.
Como o processamento assíncrono em massa melhora a qualidade dos dados para a IA?
O processamento assíncrono em massa ajuda as equipes a revisar e limpar listas de contatos extensas — de 500 a 500.000 números por tarefa — sem sobrecarregar os sistemas conversacionais em funcionamento. Ao enviar arquivos estruturados por endpoints da API e consultar o status dos trabalhos de forma assíncrona, as organizações enriquecem os CRMs com sinais de ativação e de operadora em execuções agendadas. Essa preparação em segundo plano garante dados confiáveis e prontos para os fluxos automatizados, evitando latência durante as conversas ao vivo com os clientes.
O que é a amnésia do agente e como as organizações podem combatê-la?
A amnésia do agente descreve a incapacidade de um sistema de IA de manter o contexto entre as sessões dos clientes devido a dados de backend fragmentados ou isolados em silos. As organizações combatem esse problema implementando práticas unificadas de higiene de dados. Validar regularmente as listas de telefones, confirmar os sinais de ativação e enriquecer os registros com o contexto da operadora ajuda a garantir que os agentes automatizados acessem perfis de clientes sincronizados, favorecendo a continuidade e reduzindo interações repetitivas e desconexas.
Saiba mais
Escolha as informações de produto adequadas à próxima etapa do seu fluxo de trabalho.